Binárna kopa a kompresia s pomocou Huffmanovho stromu
Kompresia
Kompresia je proces zníženia počtu bitov potrebných na reprezentáciu dát.
Dekompresia je proces uvedenia dát do pôvodného stavu.
Prečo komprimujeme?
Kompresia zmenší množstvo dát potrebných na uloženie alebo prenos.
AAAAAAAAAABBBBBBCCCCCCCCObsahuje veľa opakovaní, preto sa dá dobre komprimovať.
Q7mK2pL9xR4aT8zWNáhodné dáta sa komprimujú oveľa horšie.
Viac: Kompresia dát
Kompresia
Stratová a bezstratová
Stratová kompresia
Vynechanie nepodstatných častí. Nie je možná dekompresia do pôvodnej podoby.
- kompresia audia
- kompresia videa
Bezstratová kompresia
Zmena spôsobu zápisu informácie, Zníženie redundancie v dátach.
Je možné obnovenie do pôvodnej podoby.
- šifrovaný prenos.
- archivovanie súborov.
Bezstratová kompresia
- Premenlivá dĺžka kódového slova Kóduje často opakujúce sa sekvencie s menším počtom bitov
- Fixná dĺžka kódového slova Kóduje dáta ako tokeny
Bezstratová a stratová kompresia
| Typ | Príklady | Po dekompresii |
|---|---|---|
| Bezstratová | ZIP, PNG, FLAC | dáta sú úplne rovnaké |
| Stratová | JPEG, MP3, MPEG | dáta sú mierne zmenené |
Bezstratovú kompresiu použijeme napríklad pri zdrojovom kóde, dokumentoch alebo databázach.
Pomer kompresie
pomer = komprimovaná veľkosť / pôvodná veľkosť
úspora = 1 - pomer
Príklad:
pôvodný súbor:       1000 B
komprimovaný súbor:   600 B
úspora:                40 %
Keď kompresia nepomôže
Kompresia nemusí byť vždy úspešná. Pri krátkych alebo náhodných dátach môže výsledok narásť:
ABCD → 1A1B1C1DKompresor musí uložiť aj informáciu o opakovaní, takže pri malom vstupe môže réžia prevážiť úsporu.
Viac: Kompresia dát
📦 RLE – Run Length Encoding
RLE nahrádza súvislé opakovanie dvojicou (počet, znak).
AAAABBBAAC
 4A   3B  2A 1C
Výsledok:
4A3B2A1CViac: Run-length encoding
Kedy sa hodí RLE?
RLE funguje dobre pri obrázkoch s veľkými jednofarebnými plochami alebo pri podobných opakujúcich sa dátach.
Pri dátach bez dlhých behov opakujúcich sa znakov môže byť výsledok väčší než originál.
Príklady použitia sa nachádzajú v jednoduchých obrazových a bitmapových formátoch.
Viac: Run-length encoding
RLE v Pythone: kódovanie
def rle_encode(data: str) -> list[tuple[int, str]]:
    if not data:
        return []

    result = []
    count = 1

    for current, previous in zip(data[1:], data):
        if current == previous:
            count += 1
        else:
            result.append((count, previous))
            count = 1

    result.append((count, data[-1]))
    return result
Problém komunikácie
Vysielač -- prenosový kanál --> PríjmačAko navrhnúť efektívnu komunikáciu z vysielača tak, aby jej príjmač porozumel?
Shannon:
Základný probmém komunikácie je schopnosť príjmača identifikovať dáta generované vysielačom cez prijatý signál v prenosovom kanáli.
Teória informácií
Dáta sú množina prvkov (udalostí), ktoré sa môžu opakovať.
['prší','prší','prší','sneží','slnečno','sneží']

[1,1,2,3,2]
Teória informácií
Je možné vypočítať pravdepodobnosť každého prvku. Pravdepodobnosť je priamo úmerná početnosti:
(prší)    1 : 2
(sneží)   2 : 2
(slnečno) 3 : 1
ostatné     : nula
Výpočet početností symbolov v Pythone
from collections import Counter

data = ['prší', 'prší', 'prší',
        'sneží', 'slnečno', 'sneží']

freq = Counter(data)

print(freq)
Výstup:
Counter({
    'prší': 3,
    'sneží': 2,
    'slnečno': 1
})
Výpočet pravdepodobností
from collections import Counter

data = ['prší', 'prší', 'prší',
        'sneží', 'slnečno', 'sneží']

freq = Counter(data)
n = len(data)

for symbol, count in freq.items():
    print(symbol, count / n)
Výstup:
prší 0.5
sneží 0.333
slnečno 0.167
Entropia
je miera prekvapenia, ktoré prináša symbol.
Entropiu merieme v bitoch na symbol.
Čím je symbol zriedkavejší, tým viac informácie nesie.
- Ak sú všetky symboly rovnako pravdepodobné, entropia je maximálna.
- Ak je jeden symbol veľmi častý, entropia je nízka.
- Ak sa jeden symbol stále opakuje, entropia je nulová.
Z pravdepodobnosti vypočítame entropiu
Štatisticky analyzujeme symboly vo výslednej správe,
Počet výskytov - frekvencia - pravdepodobnosť.
\(P (z) = C (z) / N\)
Minimálne množstvo bitov, potrebné na reprezentáciu celej množiny \(Z, z \in Z\).
\(S(Z) = - \sum_z P(z) \log_2 P(z)\)
symbol s pravdepodobnosťou \(1/2\) nesie 1 bit informácie, kým symbol s pravdepodobnosťou \(1/8\) nesie 3 bity. Zriedkavejší symbol prináša väčšie prekvapenie.
Výpočet entropie
Pre množinu symbolov môžeme vypočítať Shannonovu entropiu:
from collections import Counter
from math import log2

data = ['prší', 'prší', 'prší',
        'sneží', 'slnečno', 'sneží']
freq = Counter(data)
n = len(data)

entropy = 0

for count in freq.values():
    p = count / n
    entropy -= p * log2(p)

print(entropy)
#1.459 bitu na symbol
Kódovanie
Množina vstupných symbolov v správe sa prepisuje na množinu výstupných symbolov.
Množina výstupných symbolov - kódový slovník
Spôsob zápisu množiny prvkov pomocou kódových symbolov.
[1,2,2,4,5,7,7,7]- Ako by sme zapísali v binárnom kóde túto množinu čo najefektívnejšie?
- Koľko bitov budeme potrebovať?
Kódovanie
[1,2,2,4,5,7,7,7]- ASCII kódovanie potrebuje 8 bitov na jeden znak
- Mohli by sme sa dohodnúť na nejakom inom kódovaní?
Kódové slovo
-
Unikátny spôsob zápisu jedného prvku
-
ASCII Tabuľka: - osem bitové slová
-
Morzeova abeceda : - slová s premenlivou dĺžkou
Huffmanovo kódovanie
Hľadanie optimálneho prefixového kódovania.
Optimálne kódovanie - Najčastejšie symboly by mali mať čo najkratšie kódy.
Prefixové kódovanie : Žiadne kódové slovo nie je prefixom iného kódového slova, nepotrebuje sa používať žiadny oddeľovací znak.
Správa bude stručná a jednoznačne čitateľná.
Huffmanovo kódovanie
Vychádza z pravdepodobností symbolov a vytvára binárny strom, ktorý reprezentuje kódovanie.
Máme zdroj, ktorý generuje 4 nezávislé symboly s týmito pravdepodobnosťami:
| Symbol | Pravdepodobnosť | Kód | Dĺžka | \(p \times l\) |
|---|---|---|---|---|
| A | \(1/2\) | 0 | 1 | \(0.500\) |
| B | \(1/4\) | 10 | 2 | \(0.500\) |
| C | \(1/8\) | 110 | 3 | \(0.375\) |
| D | \(1/8\) | 111 | 3 | \(0.375\) |
| Súčet | 1 | — | — | 1.75 |
Stĺpec \(p \times l\) ukazuje, koľko bitov na symbol každý znak prinesie priemerne. Súčet sa rovná entropii (1.75 bitu).
Príklad dekódovania
Ak je kódovanie nasledovné:
A→1B→00C→01
Dekódujme bitový reťazec 00011. Čítame zľava doprava a pri každom liste začíname od koreňa:
00→B01→C1→A1→A
Výsledkom je postupnosť BCAA. Kódy sú prefixové, preto vieme jednoznačne určiť, kde sa každý kód končí.
Huffmanovo kódovanie — MISSISSIPPI
Pre text "MISSISSIPPI" (11 znakov) s početnosťami:
| Symbol | Početnosť | Pravdepodobnosť | Kód | Dĺžka | \(p \times l\) |
|---|---|---|---|---|---|
| M | 1 | 1/11 ≈ 0.091 | 111 | 3 | 0.273 |
| I | 4 | 4/11 ≈ 0.364 | 0 | 1 | 0.364 |
| S | 4 | 4/11 ≈ 0.364 | 10 | 2 | 0.727 |
| P | 2 | 2/11 ≈ 0.182 | 110 | 3 | 0.545 |
| Súčet | 11 | 1 | — | — | 1.909 |
Huffmanovo kódovanie dosahuje 3.83× kompresiu oproti ASCII.
| Porovnanie | Bitov |
|---|---|
| ASCII (8 bitov/znak) | 11 × 8 = 88 |
| Huffmanovo kódovanie | 23 |
| Entropia (dolná hranica) | 11 × 1.909 ≈ 21 |
Huffmanov strom
- Všetky symboly sa dajú zoradiť do binárneho stromu podľa ich binárneho kódu.
- Cesta k uzlu je jeho binárny kód.
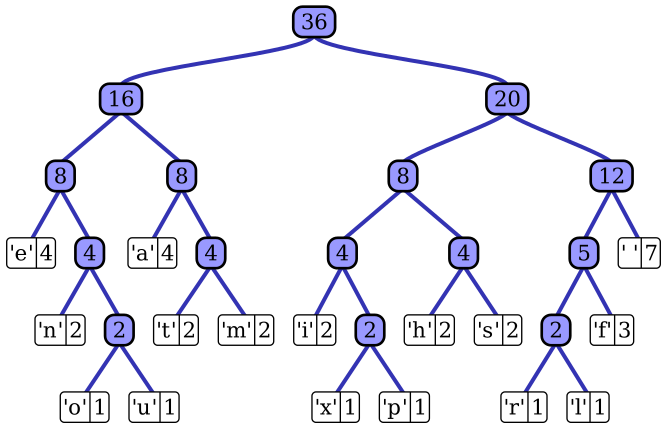
Huffmanovo kódovanie
- Vstup:: Množina symbolov a ich váhy (početnosti).
- Výstup:: Množina binárnych kódov pre každý symbol usporiadaná v Huffmanovom strome.
- Zostav tabuľku početností symbolov
- Symbol a početnosť premeň na uzol binárneho stromu a ulož do prioritnej fronty.
- Vyber prvé dva uzly v prioritnej fronte, tie s najnižšou početnosťou.
- Vytvor nový rodičovský uzol a vybrané uzly budú jeho potomkovia. Početnosť nového uzla je súčet početností jeho potomkov. Nový uzol vlož do prioritnej fronty.
- Ak vo fronte zostane jediný uzol, je koreňom binárneho Huffmanovho stromu.
Huffmanovo dekódovanie
- Vstup:: Binárny reťazec a Hufmannov strom.
- Výstup:: Postupnosť symbolov
- Začni v koreňovom uzle stromu.
- Pre každý bit v reťazci:
- Ak je bit
0, choď do ľavého potomka. - Ak je bit
1, choď do pravého potomka.
- Ak je bit
- Ak sa dostaneš do listového uzla, pridaj symbol do výstupu a vráť sa do koreňa stromu.
- Opakuj, kým neprečítaš všetky bity.
Huffmanov strom je prefixový (trie), takže dekódovanie je jednoznačné.
Príklad: Zostavte Huffmanov strom pre text "MISSISSIPPI":
| Symbol | Početnosť |
|---|---|
| M | 1 |
| I | 4 |
| S | 4 |
| P | 2 |
        *
       / \
      *   I
     / \
    *   S
   / \
  M   P
Uzol Huffmanovho stromu
class Node:
    def __init__(self, freq, symbol=None,
                 left=None, right=None):
        self.freq = freq
        self.symbol = symbol
        self.left = left
        self.right = right

    # Prekrytie metódy < umožňuje porovnávať uzly podľa frekvencie
    def __lt__(self, other):
        return self.freq < other.freq
Metóda __lt__ umožňuje ukladať uzly do prioritnej fronty.
Vytvorenie Huffmanovho stromu
from collections import Counter
text = "MISSISSIPPI"
# spočítame znaky a zotriedime podľa frekvencie
pool = sorted(
    Node(freq, symbol)
    for symbol, freq in Counter(text).items()
)
while len(pool) > 1:
    # dva najmenšie uzly (už zoradené)
    left, right = pool.pop(0), pool.pop(0)
    parent = Node(
        left.freq + right.freq,
        left=left,
        right=right
    )
    pool.append(parent)
    # po pridaní nového uzla je potrebné znovu zotriediť frontu
    # triedenie má typicky zložitosť n log(n)
    pool.sort(key=lambda n: n.freq)

# Celý algoritmus má zložitosť n^2 log(n)
root = pool[0]
Generovanie Huffmanových kódov
def build_codes(node, prefix="", codes=None):
    if codes is None:
        codes = {}

    if node.symbol is not None:
        codes[node.symbol] = prefix
        return codes

    build_codes(node.left, prefix + "0", codes)
    build_codes(node.right, prefix + "1", codes)

    return codes
Možný výstup:
I 0
S 10
P 110
M 1110
Implementácia prioritnej fronty pomocou poľa je neefektívna,
vyžaduje opakované triedenie poľa pri každom vložení alebo výbere.
- Efektívnejšie je použiť binárnu kopu alebo binárny strom, ktoré umožňujú vloženie a odobratie minima v čase
O(log n). - často sa používa binárna kopa, pretože je jednoduchá na implementáciu a efektívne využíva pamäť.
- binárny strom je flexibilnejší, umožňuje rýchlejšie vyhľadávanie a odstraňovanie ľubovoľného uzla, ale je zložitejší na implementáciu a vyžaduje viac pamäte.
# zostavenie Huffumanovho stromu s použitím heapq
import heapq
class Node:
    def __init__(self, freq, symbol=None,
                 left=None, right=None):
        self.freq = freq
        self.symbol = symbol
        self.left = left
        self.right = right
    def __lt__(self, other):
        return self.freq < other.freq

def build_huffman_tree(text):
    freq = Counter(text)
    heap = [Node(f, s) for s, f in freq.items()]
    heapq.heapify(heap)
    while len(heap) > 1:
        left = heapq.heappop(heap)
        right = heapq.heappop(heap)
        parent = Node(left.freq + right.freq, left=left, right=right)
        heapq.heappush(heap, parent)
    return heap[0]
Binárna kopa
Prioritná fronta vracia vždy prvok s najvyššou (alebo najnižšou) prioritou.
Binárna kopa je efektívna dátová štruktúra na jej implementáciu:
- vloženie aj odobratie minima trvá
O(log n), pohľad na minimumO(1). - pamäťová náročnosť je
O(n), čo je lepšie akoO(n log n)pri implementácii pomocou binárneho stromu.
Kopa uložená v poli
Pri indexovaní od 0 platí pre uzol na pozícii i:
- ľavý potomok:
2 * i + 1 - pravý potomok:
2 * i + 2 - rodič:
(i - 1) // 2
Vďaka tomu netreba v poli ukladať odkazy na rodičov ani potomkov.
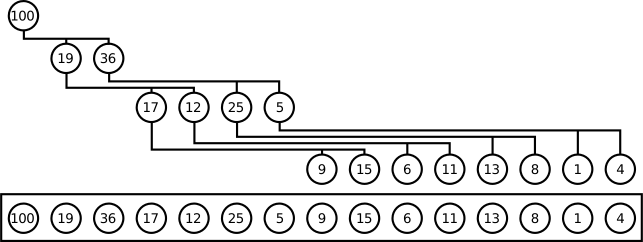
Binárna kopa je takmer úplný binárny strom uložený v poli.
- Všetky úrovne okrem poslednej sú úplné.
- Posledná úroveň sa vypĺňa zľava doprava.
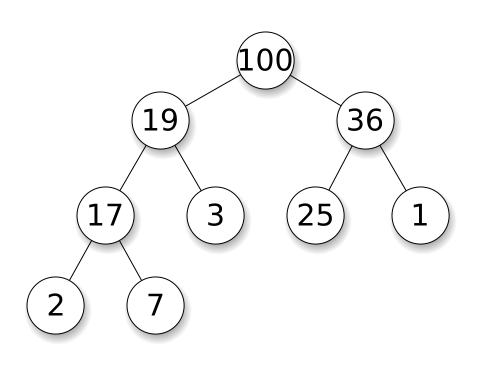
Kopovitosť
V minimálnej kope má každý rodič hodnotu menšiu alebo rovnakú ako jeho potomkovia. Najmenší prvok je preto vždy v koreni.
Nezáleží na tom, či je menší prvok v ľavom alebo pravom podstrome, dôležité je, že je menší ako jeho rodič.
        1
       / \
      2   3
     / \
    4   5
Takmer úplný strom
- Strom je takmer úplný, ak sú všetky úrovne okrem poslednej úplne zaplnené a posledná úroveň je zaplnená zľava doprava.
- Výška takmer úplného stromu je logaritmická vzhľadom na počet uzlov. Preto operácie v binárnej kope trvajú
O(log n)
Príklad na takmer úplný strom:
        1
       / \
      2   3
     / \  /
    4   5 6
Takmer úplnný strom je efektívny na ukladanie do poľa, pretože v poli nemusíme uchovávať žiadne prázdne miesta, ani odkazy na rodičov alebo potomkov.
Pridanie a odobratie prvku
- Pridanie: nový prvok vložíme na koniec poľa a posúvame ho k rodičovi, kým platí kopovitosť.
- Odobratie minima: koreň nahradíme posledným prvkom, pole skrátime a nový koreň posúvame nadol.
- Obe operácie trvajú
O(log n), pretože výška takmer úplného stromu je logaritmická.
Obnovenie kopovitosti pre n-tý prvok
- Porovnaj hodnotu uzla s jeho potomkami.
- Ak je uzol väčší ako niektorý z potomkov, vymeň ich hodnoty a pokračuj s potomkom, ktorý bol menší.
- Opakuj, kým uzol nie je menší ako jeho potomkovia alebo sa dostaneš na list.
def heapify(arr, n, i):
    smallest = i
    left = 2 * i + 1
    right = 2 * i + 2

    if left < n and arr < arr[smallest]:
        smallest = left

    if right < n and arr < arr[smallest]:
        smallest = right

    if smallest != i:
        arr[i], arr[smallest] = arr[smallest], arr[i]
        heapify(arr, n, smallest)
Zložitosť je O(log n), pretože v najhoršom prípade sa musíme prejsť z koreňa až na list.
Obnovenie kopovitosti ľubovoľného poľa
- Začneme od posledného rodiča a postupujeme smerom k koreňu.
- Pre každý uzol obnovíme kopovitosť pomocou heapify.
- Po dokončení budeme mať z poľa binárnu kópu.
def build_heap(arr):
    n = len(arr)
    # V druhej polovici poľa sú listy, ktoré sú už kopovité.
    for i in range(n // 2 - 1, -1, -1):
        heapify(arr, n, i)
Heap Sort
Využijeme fakt, že výsledkom obnovenia kopovitosti je minimálny prvok na prvom mieste.
def heap_sort(arr):
    n = len(arr)
    build_heap(arr)

    for i in range(n - 1, 0, -1):
        arr[0], arr[i] = arr[i], arr[0]
        heapify(arr, i, 0)
Zhrnutie
- Binárna kopa je efektívna dátová štruktúra na implementáciu prioritnej fronty.
- Binárna kopa je takmer úplný binárny strom uložený v poli, ktorý umožňuje efektívne pridávanie a odoberanie prvkov.
- Huffmanovo kódovanie je efektívna metóda bezstratovej kompresie, ktorá využíva binárny strom na reprezentáciu kódov symbolov podľa ich pravdepodobností.
- Huffmanov strom je prefixový, čo umožňuje jednoznačné dekódovanie