Klaudová prevádzka (Cloud Operations)
Nasadením aplikácie sa práca nekončí. Služba musí zostať dostupná, bezpečná, primerane výkonná a finančne udržateľná aj počas zmien, porúch a nárastov záťaže. Klaudová prevádzka (Cloud Operations, CloudOps) zahŕňa postupy a nástroje, ktoré zabezpečujú každodennú prevádzku klaudovej infraštruktúry a služieb.
CloudOps nie je iba sledovanie grafov ani ručné opravovanie serverov. Patrí sem príprava infraštruktúry, riadenie kapacity, aktualizácie, monitoring, reakcia na incidenty, zálohovanie, obnova, bezpečnosť aj kontrola nákladov. Prevádzkový cyklus znázorňuje obrázok 7.1.
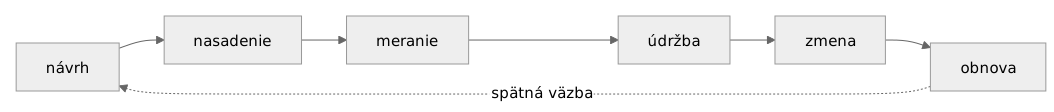
Obrázok 7.1: Prevádzkový cyklus služby
CloudOps a DevOps
DevOps a CloudOps sa prekrývajú, ale neoznačujú presne to isté.
| Oblasť | DevOps | CloudOps |
|---|---|---|
| Hlavné zameranie | tok zmeny od kódu do produkcie | spoľahlivá každodenná prevádzka |
| Typické úlohy | build, test, release, deployment | kapacita, dostupnosť, monitoring, backup |
| Typické nástroje | Git, CI/CD, registry | Terraform, Ansible, Prometheus, Grafana |
| Spoločné oblasti | automatizácia, bezpečnosť, meranie, incidenty | automatizácia, bezpečnosť, meranie, incidenty |
V menšom tíme môžu obe oblasti zabezpečovať tí istí ľudia. Rozdelenie názvov nemení fakt, že za správanie služby v produkcii musí mať niekto jasnú zodpovednosť.
Operácie nultého, prvého a druhého dňa
Životný cyklus systému sa často delí na tri skupiny činností. Slovo deň tu neoznačuje presný kalendárny deň, ale etapu prevádzky.
| Etapa | Otázka | Príklady |
|---|---|---|
| Day 0 | Čo a ako budeme prevádzkovať? | architektúra, kapacita, bezpečnosť, IaC, SLO, plán obnovy |
| Day 1 | Ako systém prvýkrát nasadiť? | vytvorenie zdrojov, konfigurácia, migrácia dát, overenie nasadenia |
| Day 2 | Ako ho dlhodobo udržíme? | monitoring, aktualizácie, škálovanie, incidenty, backup, optimalizácia nákladov |
Už počas day 0 treba navrhnúť, ako sa bude systém pozorovať a obnovovať. Ak sa monitoring alebo zálohy pridajú až po prvom incidente, tím nemusí mať údaje potrebné na určenie príčiny ani funkčnú cestu obnovy.
Zodpovednosti prevádzky
Konkrétne rozdelenie práce závisí od modelu služby. Pri IaaS spravuje zákazník operačný systém, aktualizácie a aplikácie. Pri spravovanej databáze zabezpečuje poskytovateľ viac úloh, ale zákazník naďalej zodpovedá napríklad za prístupové práva, konfiguráciu záloh a ochranu dát.
Prevádzkový tím typicky zabezpečuje:
- inventár a vlastníctvo zdrojov,
- prístupy s najmenšími potrebnými oprávneniami,
- automatizované vytváranie a konfiguráciu prostredí,
- kapacitu, dostupnosť a výkon,
- aktualizácie operačných systémov a aplikácií,
- metriky, logy, distribuované stopy a alerty,
- zálohovanie, testovanie obnovy a disaster recovery,
- riešenie incidentov a dokumentovanie poznatkov,
- rozpočty, tagovanie a optimalizáciu nákladov.
Infrastructure as Code
Infrastructure as Code (IaC) znamená, že infraštruktúru a jej konfiguráciu opisujeme v súboroch, ktoré možno kontrolovať, verzovať, testovať a opakovane použiť. Namiesto série kliknutí v administračnom rozhraní vzniká kontrolovateľný záznam požadovaného stavu. Deklaratívny pracovný model Terraformu opisuje jeho oficiálna časť Infrastructure as Code. Pracovný tok IaC znázorňuje obrázok 7.2.
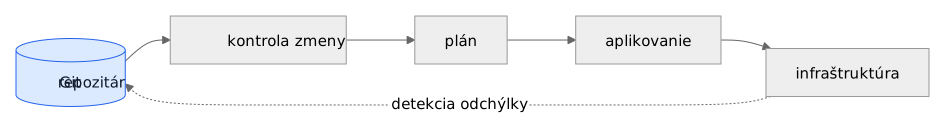
Obrázok 7.2: Pracovný tok infraštruktúry ako kódu
IaC prináša najmä opakovateľnosť, verzovanie, automatizáciu, kontrolu zmien a obnoviteľnosť. IaC sám osebe nezaručuje správny návrh. Chybná konfigurácia iba umožní chybu zopakovať rýchlejšie. Zmeny preto prechádzajú kontrolou syntaxe, plánom, testami a review.
Deklaratívny a imperatívny prístup
Imperatívna konfigurácia opisuje kroky: vytvor sieť, vytvor server a spusti službu. Deklaratívna konfigurácia opisuje cieľ: sieť a server majú existovať a služba má bežať. Nástroj porovná požadovaný stav so skutočným a navrhne potrebné zmeny.
S tým súvisí idempotencia. Opakované spustenie konfigurácie nad systémom, ktorý jej už vyhovuje, by nemalo robiť zbytočné zmeny. Príkaz „nainštaluj balík, ak chýba“ je idempotentný; príkaz „vždy pridaj tento riadok na koniec súboru“ ním bez ďalšej kontroly nie je.
Provisioning a configuration management
| Úloha | Typický nástroj | Príklad |
|---|---|---|
| vytvorenie klaudových zdrojov | Terraform | VPC, virtuálny server, databáza |
| konfigurácia operačného systému | Ansible | balíky, používatelia, konfiguračné súbory |
| lokálne kontajnery | Docker Compose | aplikácia, databáza, monitoring |
| požadovaný stav klastra | Kubernetes manifesty | Deployment, Service, ConfigMap |
Hranica nie je absolútna. Oddelenie provisioningu od konfigurácie však zvyčajne zjednodušuje vlastníctvo a diagnostiku.
Drift a bezpečnosť konfigurácie
Configuration drift je rozdiel medzi deklarovaným a skutočným stavom. Vzniká napríklad ručnou zmenou firewallu mimo IaC. Pravidelný plán dokáže odchýlku odhaliť, no jej automatická oprava musí zohľadniť dopad na službu.
Do repozitára nepatria heslá, API kľúče, privátne kľúče ani produkčné state súbory. Tajomstvá sa načítajú zo správcu tajomstiev alebo z chráneného prostredia automatizácie. Log ani plán ich nesmie nechtiac zverejniť.
Terraform
Terraform je deklaratívny nástroj od spoločnosti HashiCorp. Cez provider plugins komunikuje s API poskytovateľa a spravuje objekty deklarované ako resources. Konfigurácia používa jazyk HCL; vzťah konfigurácie, providerov a state vysvetľuje Terraform documentation. Vzťah komponentov Terraformu znázorňuje obrázok 7.3.
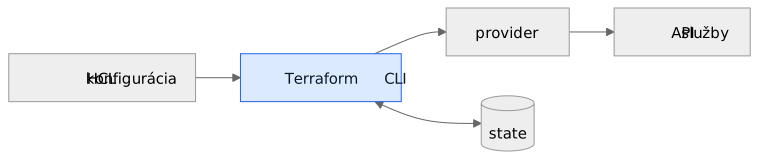
Obrázok 7.3: Komponenty Terraformu
Konfigurácia HCL
Nasledujúci lokálny príklad vytvorí textový súbor. Nejde o klaudovú infraštruktúru, ale ukazuje rovnaké prvky konfigurácie bez potreby klaudového účtu.
terraform {
  required_version = ">= 1.10.0"

  required_providers {
    local = {
      source  = "hashicorp/local"
      version = "~> 2.5"
    }
  }
}

variable "obsah" {
  description = "Obsah vygenerovaneho suboru"
  type        = string
  default     = "Cloud Operations\n"
}

resource "local_file" "demo" {
  filename = "${path.module}/vystup.txt"
  content  = var.obsah
}

output "cesta" {
  description = "Cesta k vytvorenemu suboru"
  value       = local_file.demo.filename
}
Blok terraform určuje verzie, variable definuje vstup, resource spravovaný objekt a output zverejní vybranú hodnotu.
Základný workflow
terraform init
terraform fmt -check
terraform validate
terraform plan -out=tfplan
terraform apply tfplan
terraform output
terraform destroy
init pripraví pracovný adresár, fmt zjednotí formát, validate skontroluje konfiguráciu a plan zobrazí rozdiel pred zásahom. apply vykoná schválený plán. destroy naplánuje odstránenie spravovaných objektov. Uložený plán treba chrániť podobne ako state, pretože môže obsahovať citlivé hodnoty.
State management
Terraform si v state udržiava väzbu medzi konfiguráciou a skutočnými objektmi. Lokálne používa terraform.tfstate. V tíme sa používa vzdialený backend s riadením prístupu, šifrovaním, históriou a lockingom, aby dve operácie nemenili ten istý stav súčasne.
State sa neupravuje ručne. Príkazy terraform state a import sa používajú opatrne a po vytvorení zálohy. Modul zoskupuje súvisiace zdroje za vstupmi a výstupmi. Produkčné a testovacie prostredie nemajú bez rozmyslu zdieľať jeden state; oddelenie obmedzuje rozsah chyby a umožňuje samostatné oprávnenia.
Ansible
Ansible automatizuje konfiguráciu operačných systémov a aplikácií. Je agentless: na spravovaných linuxových uzloch zvyčajne nepotrebuje vlastného agenta a pripája sa cez SSH. Architektúru inventára, playbookov, modulov a pluginov opisuje prehľad základných konceptov Ansible. Princíp práce Ansible znázorňuje obrázok 7.4.
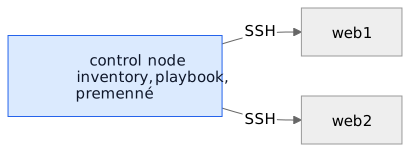
Obrázok 7.4: Ansible spravuje servery cez SSH
- inventory obsahuje spravované hosty a skupiny,
- playbook spája skupinu hostov so zoznamom úloh,
- module vykoná konkrétnu operáciu,
- variable oddeľuje meniace sa hodnoty,
- template generuje konfiguráciu pomocou Jinja2,
- handler sa spustí po oznámenej zmene,
- role organizuje rozsiahlejšiu automatizáciu.
Inventory:
[web]
web1 ansible_host=192.0.2.10 ansible_user=student
web2 ansible_host=192.0.2.11 ansible_user=student
Adresy z rozsahu 192.0.2.0/24 sú dokumentačné a treba ich nahradiť adresami testovacích serverov.
Idempotentný playbook
---
- name: Configure web servers
  hosts: web
  become: true

  tasks:
    - name: Install Nginx
      ansible.builtin.apt:
        name: nginx
        state: present
        update_cache: true

    - name: Publish course page
      ansible.builtin.copy:
        dest: /var/www/html/index.html
        content: "Server configured by Ansible\n"
        owner: root
        group: root
        mode: "0644"
      notify: Restart Nginx

    - name: Enable and start Nginx
      ansible.builtin.service:
        name: nginx
        enabled: true
        state: started

  handlers:
    - name: Restart Nginx
      ansible.builtin.service:
        name: nginx
        state: restarted
Použitie modulov je bezpečnejšie než séria neštruktúrovaných shell príkazov. Pri druhom spustení bez zmeny obsahu by playbook nemal hlásiť zmenené úlohy ani spustiť handler.
ansible-inventory -i inventory.ini --graph
ansible web -i inventory.ini -m ansible.builtin.ping
ansible-playbook -i inventory.ini web.yaml --syntax-check
ansible-playbook -i inventory.ini web.yaml --check --diff
ansible-playbook -i inventory.ini web.yaml
Check mode je náhľad, nie záruka presného výsledku. Citlivé premenné možno šifrovať pomocou Ansible Vault; heslo k Vaultu nepatrí do repozitára.
Dostupnosť, škálovanie a údržba
Dostupnosť vyjadruje, akú časť sledovaného obdobia je služba použiteľná. Repliky musia byť rozložené medzi nezávislé failure domains a systém musí rozpoznať nezdravú inštanciu. Jednoduchý príklad rozloženia záťaže ukazuje obrázok 7.5.
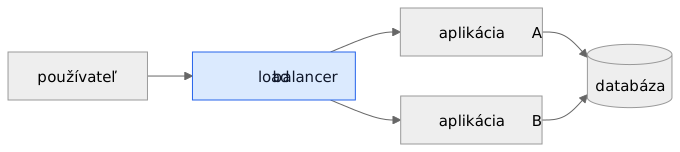
Obrázok 7.5: Rozdelenie záťaže medzi dve inštancie aplikácie
- Vertikálne škálovanie pridá CPU alebo pamäť uzlu. Je jednoduché, ale narazí na limit jedného stroja.
- Horizontálne škálovanie pridá inštancie. Zvyšuje odolnosť, ale aplikácia musí riešiť zdieľaný stav.
- Autoscaling mení kapacitu podľa metrík alebo plánu. Reaguje s oneskorením, preto nenahrádza rezervu.
- Load balancer rozdeľuje požiadavky a pomocou health checks vyraďuje nezdravé ciele.
Dve aplikačné repliky nepomôžu, ak obe závisia od jedinej databázy bez obnovy alebo od jedného sieťového prvku.
Patch management zahŕňa inventár verzií, hodnotenie zraniteľností, testovanie, naplánovanie zmeny, rollout a overenie. Rolling update postupne nahrádza inštancie, blue-green prepne na pripravené nové prostredie a canary pošle novej verzii iba malú časť prevádzky. Pred zmenou musí byť známy rollback alebo roll-forward postup.
Monitoring a observabilita
Monitoring odpovedá na vopred položené otázky. Observabilita pomáha porozumieť vnútornému stavu systému z jeho výstupov aj pri probléme, ktorý sme vopred presne nepredpovedali.
| Signál | Otázka | Príklad |
|---|---|---|
| metriky | čo sa deje v čase? | počet požiadaviek, chybovosť, CPU |
| logy | aká konkrétna udalosť nastala? | chyba s časom a request ID |
| traces | kadiaľ prešla požiadavka? | volania API, databázy a frontu |
Pre službu sú užitočné štyri signály: latencia, traffic, errors a saturation. Tento rámec zavádza kapitola Monitoring Distributed Systems v knihe Google SRE. CPU, RAM a disk sú dôležité, ale nehovoria priamo, či používateľ dokončil svoju úlohu.
SLI, SLO a SLA
- SLI je nameraná hodnota, napríklad podiel úspešných požiadaviek.
- SLO je interný cieľ, napríklad 99,9 % úspešných požiadaviek za 30 dní.
- SLA je dohoda so zákazníkom a môže obsahovať následky nesplnenia.
SLO nižšie než 100 % vytvára error budget. Ak ho služba rýchlo spotrebúva, tím obmedzí rizikové zmeny a venuje sa spoľahlivosti. Rozhodovanie podľa SLO znázorňuje obrázok 7.6.
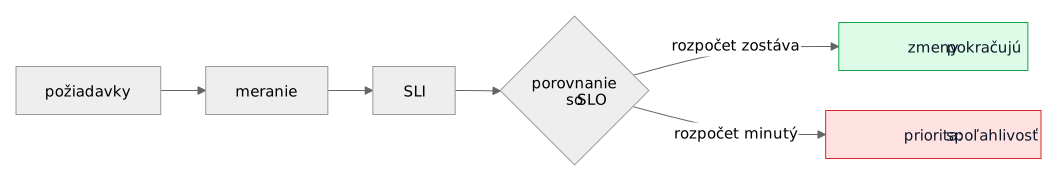
Obrázok 7.6: Vyhodnotenie SLI voči SLO a error budget
Prometheus a Grafana
Prometheus zbiera a ukladá metriky ako časové rady. Najčastejšie si ich sťahuje z HTTP endpointu /metrics. Pre operačný systém, databázu alebo inú službu sa používa exporter. Dátový model, typy metrík a spôsob zberu opisuje Prometheus documentation. Tok metrík znázorňuje obrázok 7.7.
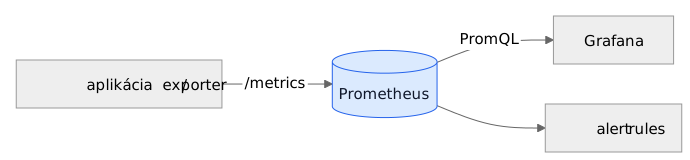
Obrázok 7.7: Monitoring s Prometheom a Grafanou
Časovú radu určuje názov metriky a labels:
http_requests_total{method="GET",status="200",instance="web1"} 1842Každá kombinácia labels vytvára novú radu. E-mail alebo request ID preto do labels nepatria; vysoká kardinalita zvyšuje spotrebu pamäte a úložiska.
- counter iba rastie alebo sa po reštarte vynuluje,
- gauge môže rásť aj klesať,
- histogram rozdeľuje pozorovania do bucketov,
- summary počíta vybrané štatistiky na strane klienta.
Základné PromQL dotazy:
up100 * (1 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m])))100 * (1 - node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes)Grafana vizualizuje údaje z externých zdrojov. Data source opisuje pripojenie, dashboard zoskupuje panely, panel vykresľuje dotazy a variable umožní meniť napríklad inštanciu bez kopírovania dashboardu.
Alert má upozorniť na stav, ktorý vyžaduje činnosť. Potrebuje jasný opis dopadu, primerané trvanie, severity, vlastníka a odkaz na runbook. Upozornenia, na ktoré nikto nemusí reagovať, patria skôr do dashboardu alebo reportu.
Praktické cvičenie: Prometheus a Grafana
Praktické cvičenie spustí na linuxovom hostiteľovi Prometheus, Grafanu a Node Exporter. Publikované porty, jednoduché heslo a chýbajúce TLS nie sú vhodné pre produkciu. Node Exporter na Docker Desktop nemusí zobrazovať metriky fyzického hostiteľa.
monitoring-lab/
├── compose.yaml
├── prometheus/
│   ├── prometheus.yml
│   └── rules.yml
└── grafana/provisioning/datasources/prometheus.yaml
Docker Compose
Súbor compose.yaml:
services:
  prometheus:
    image: prom/prometheus:v3.14.0
    command:
      - --config.file=/etc/prometheus/prometheus.yml
      - --storage.tsdb.path=/prometheus
    ports:
      - "9090:9090"
    volumes:
      - ./prometheus/prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - ./prometheus/rules.yml:/etc/prometheus/rules.yml:ro
      - prometheus-data:/prometheus
    restart: unless-stopped

  node-exporter:
    image: prom/node-exporter:v1.12.1
    command:
      - --path.procfs=/host/proc
      - --path.sysfs=/host/sys
      - --path.rootfs=/host/root
      - --collector.filesystem.mount-points-exclude=^/(sys|proc|dev|host|etc)($$|/)
    volumes:
      - /proc:/host/proc:ro
      - /sys:/host/sys:ro
      - /:/host/root:ro,rslave
    restart: unless-stopped

  grafana:
    image: grafana/grafana:13.1.0
    depends_on:
      - prometheus
    environment:
      GF_SECURITY_ADMIN_USER: admin
      GF_SECURITY_ADMIN_PASSWORD: skola-lab
    ports:
      - "3000:3000"
    volumes:
      - ./grafana/provisioning:/etc/grafana/provisioning:ro
      - grafana-data:/var/lib/grafana
    restart: unless-stopped

volumes:
  prometheus-data:
  grafana-data:
Dvojitý znak $$ zabráni tomu, aby Compose spracoval znak $ ako interpoláciu premennej.
Konfigurácia Promethea
Súbor prometheus/prometheus.yml:
global:
  scrape_interval: 15s
  evaluation_interval: 15s

rule_files:
  - /etc/prometheus/rules.yml

scrape_configs:
  - job_name: prometheus
    static_configs:
      - targets: ["prometheus:9090"]

  - job_name: node
    static_configs:
      - targets: ["node-exporter:9100"]
Názvy služieb fungujú ako DNS mená vo vnútornej sieti Compose. localhost by v kontajneri Promethea označoval samotný kontajner.
Súbor prometheus/rules.yml:
groups:
  - name: availability
    rules:
      - alert: InstanceDown
        expr: up{job="node"} == 0
        for: 1m
        labels:
          severity: warning
        annotations:
          summary: "Node Exporter is unreachable"
          description: "Prometheus cannot scrape {{ $labels.instance }} for one minute."
Prometheus zobrazí stav pravidla, ale praktické cvičenie nepripája Alertmanager ani externý komunikačný kanál.
Provisioning Grafany
Súbor grafana/provisioning/datasources/prometheus.yaml:
apiVersion: 1

datasources:
  - name: Prometheus
    type: prometheus
    access: proxy
    url: http://prometheus:9090
    isDefault: true
    editable: false
Datasource sa vytvorí pri štarte Grafany.
Spustenie a kontrola
docker compose config
docker compose up -d
docker compose ps
Prometheus otvorte na http://localhost:9090 a v Status > Target health overte targety prometheus a node. V časti Query vyskúšajte up a predošlé PromQL dotazy.
Grafanu otvorte na http://localhost:3000 a prihláste sa menom admin a heslom skola-lab. V Connections > Data sources skontrolujte Prometheus. Dashboard doplňte o panely pre stav targetov, CPU a pamäť.
Výpadok nasimulujte:
docker compose stop node-exporterHodnota up{job="node"} klesne na 0. Po jednej minúte prejde InstanceDown zo stavu pending do firing. Exporter obnovte a prostredie napokon odstráňte:
docker compose start node-exporter
docker compose down
Pomenované zväzky ostanú zachované. Príkaz docker compose down --volumes ich odstráni spolu s lokálnou históriou metrík a dátami Grafany.
Logovanie, audit a incidenty
Produkčné logy majú byť štruktúrované, označené časom, prostredím, službou a korelačným identifikátorom. Nesmú obsahovať heslá, tokeny ani osobné údaje bez oprávneného dôvodu a ochrany. Aplikačné a systémové logy dopĺňajú audit logy o tom, kto a čo zmenil, a bezpečnostné udalosti, napríklad neúspešné prihlásenia.
Incident je neplánované narušenie alebo zhoršenie služby. Prioritou je obmedziť dopad a obnoviť službu, nie okamžite dokázať konečnú koreňovú príčinu. Fázy riešenia incidentu znázorňuje obrázok 7.8.

Obrázok 7.8: Priebeh riešenia incidentu
Počas závažného incidentu sa určí koordinátor, technickí riešitelia a osoba pre komunikáciu. Runbook opisuje konkrétny overený postup. Postmortem zachytí dopad, časovú os, príčiny a nápravné úlohy s vlastníkom a termínom. Sústredí sa na zlepšenie systému, nie na hľadanie vinníka.
Zálohovanie a obnova
Záloha je užitočná iba vtedy, ak z nej možno v požadovanom čase obnoviť správne dáta.
- RPO určuje prijateľnú stratu dát vyjadrenú časom.
- RTO určuje cieľový čas obnovenia služby.
- Snapshot rýchlo zachytí stav, ale môže zostať v rovnakej failure domain.
- Replikácia skracuje obnovu, ale môže preniesť chybné vymazanie.
- Immutable backup nemožno po určený čas prepísať ani vymazať bežným oprávnením.
Pravidlo 3-2-1 odporúča tri kópie dát, dve rôzne médiá alebo systémy a jednu kópiu mimo hlavnej lokality. Test obnovy overí dáta, prístupy, kľúče, konfiguráciu, poradie krokov a skutočný čas. Výsledok sa porovná s RPO a RTO.
Správa nákladov
Model pay-as-you-go neznamená automaticky nižšiu cenu. Každý zdroj preto potrebuje vlastníka, účel a priradenie nákladov.
- povinné tagy
owner,environment,serviceacost-center, - rozpočty a upozornenia na neobvyklý rast,
- odstraňovanie nepoužívaných diskov, IP adries a snapshotov,
- rightsizing podľa dlhodobo nameraného využitia,
- vypínanie vývojových prostredí mimo dohodnutého času,
- vhodná kombinácia priebežnej, rezervovanej a spot kapacity,
- sledovanie ceny prenosu dát, logov a spravovaných služieb.
Rezervácia znižuje cenu stabilnej záťaže, ale vytvára záväzok. Spot kapacita je lacnejšia, no prerušiteľná, preto patrí k nahraditeľným alebo dávkovým úlohám. Optimalizácia nesmie ignorovať spoľahlivosť a cenu ručnej práce.
Kontrolný zoznam prevádzky
- Každý zdroj a služba majú vlastníka.
- Infraštruktúra a konfigurácia sú verzované a kontrolované cez review.
- Produkčné prístupy používajú najmenšie potrebné oprávnenia.
- Služba má definované SLI, SLO a použiteľné dashboardy.
- Alerty majú vlastníka, severity a runbook.
- Aktualizácie majú rollback alebo roll-forward postup.
- Zálohy sú oddelené, chránené a testované obnovou.
- Incidenty majú komunikačný postup a vedú ku konkrétnym zlepšeniam.
- Náklady sa dajú priradiť službe a majú rozpočtové alerty.
Cvičenia
- Zaraďte vytvorenie VPC, prvé nasadenie, rotáciu certifikátu a obnovu databázy medzi day 0, day 1 a day 2 operations.
- Upravte Terraform príklad tak, aby prijímal názov výstupného súboru. Porovnajte dva plány bez zmeny konfigurácie.
- Spustite Ansible playbook dvakrát a vysvetlite výsledky
okachanged. Potom zmeňte obsah a sledujte handler. - Doplňte Grafana panel pre voľné miesto na koreňovom filesystéme.
- Zmeňte trvanie
InstanceDownna päť minút a opíšte kompromis medzi rýchlosťou detekcie a falošnými poplachmi. - Navrhnite SLI a SLO pre školský informačný systém.
- Navrhnite zálohovanie databázy s RPO 15 minút a RTO dve hodiny vrátane testu obnovy.
- Pre modelový incident pripravte časovú os, triage a dve merateľné nápravné úlohy.
Zhrnutie
Klaudová prevádzka pokrýva prevádzkový cyklus služby od návrhu a nasadenia po monitoring, aktualizácie, incidenty, obnovu a náklady. IaC mení ručné nastavenia na verzovaný proces. Terraform spravuje životný cyklus infraštruktúry pomocou konfigurácie a state, zatiaľ čo Ansible slúži na idempotentnú konfiguráciu systémov.
Prometheus zbiera časové rady a vyhodnocuje PromQL a alert rules. Grafana ich sprístupňuje cez dashboardy. Spoľahlivá prevádzka spája automatizáciu, pozorovateľnosť, pripravenú obnovu, disciplinované riešenie incidentov a kontrolu nákladov.
Odporúčaná literatúra
- Terraform – dokumentácia
- Terraform state
- Ansible – dokumentácia
- Prometheus – Getting started
- PromQL – základy
- Grafana – dokumentácia
- Grafana provisioning
- Google SRE Book
- Betsy Beyer et al.: Site Reliability Engineering, O'Reilly Media, 2016
- Kief Morris: Infrastructure as Code, 2. vydanie, O'Reilly Media, 2020
- Charity Majors, Liz Fong-Jones, George Miranda: Observability Engineering, O'Reilly Media, 2022